<figure><img src="https://rss.neurootlichnik.ru/images/2d51bb3d-45a7-460e-8882-832628fa2783/0.jpg"></figure>
<p>Google представил новую модель <b>DiarizationLM-Gemma-4-E4B</b>, предназначенную для пост-обработки диаризации говорящих. Эта модель, основанная на архитектуре 4B, значительно улучшает качество расшифровки, исправляя метки спикеров и снижая количество ошибок в диаризации.</p>
<p>Одной из ключевых особенностей <b>Gemma 4 E4B</b> является способность исправлять короткие вставки, состоящие из 1-5 слов, при этом сохраняя акустические якоря в более длинных репликах. Это позволяет модели более точно определять границы реплик и «backchannels», что особенно важно для естественного звучания диалогов.</p>
<p>Модель работает из коробки: достаточно подать гипотезу с тегами, и она вернёт исправленную версию. Это делает её удобной для использования в различных приложениях, где требуется высокая точность распознавания речи.</p>
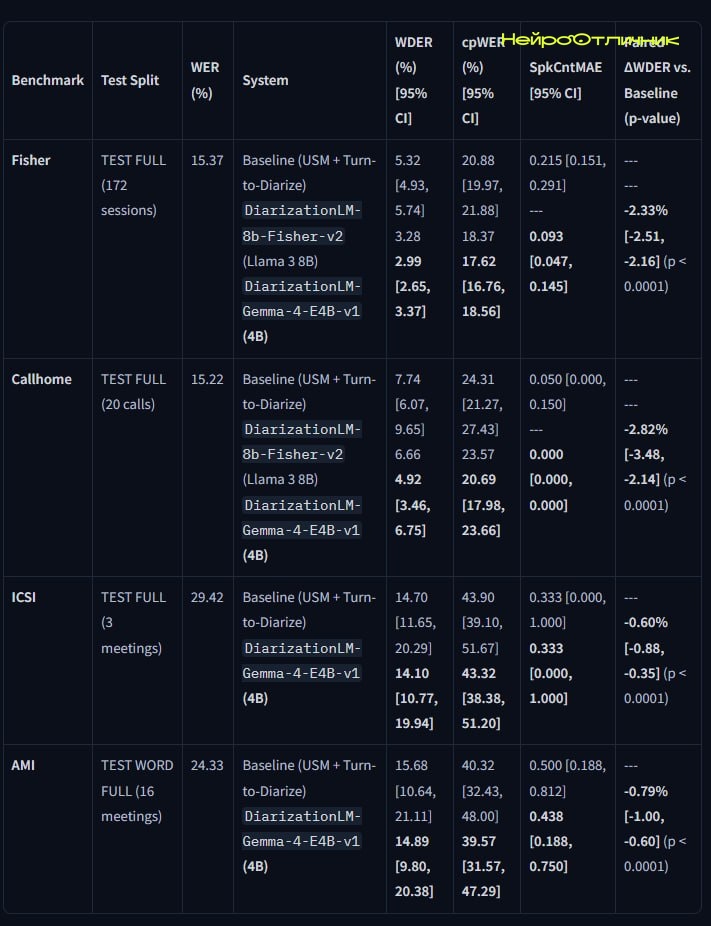
<p>Сравнительные тесты показали, что <b>DiarizationLM-Gemma-4-E4B</b> демонстрирует статистически значимые улучшения по показателям WDER и cpWER на четырёх бенчмарках, включая Fisher, Callhome, ICSI и AMI, с результатами, превышающими <b>p.</p>
<p>Основные характеристики модели:</p>
<ul><li>Исправление меток говорящих в расшифровке.</li><li>Корректировка границ реплик и коротких вставок.</li><li>Сохранение идентичности спикера в длинных монологах.</li><li>Работа без необходимости дополнительной настройки.</li></ul>
<p>С моделью <b>DiarizationLM-Gemma-4-E4B</b> Google продолжает улучшать технологии распознавания речи, предлагая пользователям более точные и удобные инструменты для работы с аудиоданными.</p>
Нейро Отличник
www.neurootlichnik.ru