<figure><img src="https://rss.neurootlichnik.ru/images/d3491604-5da9-48f6-b81e-7f3f30cf9daf/0.jpg"></figure>
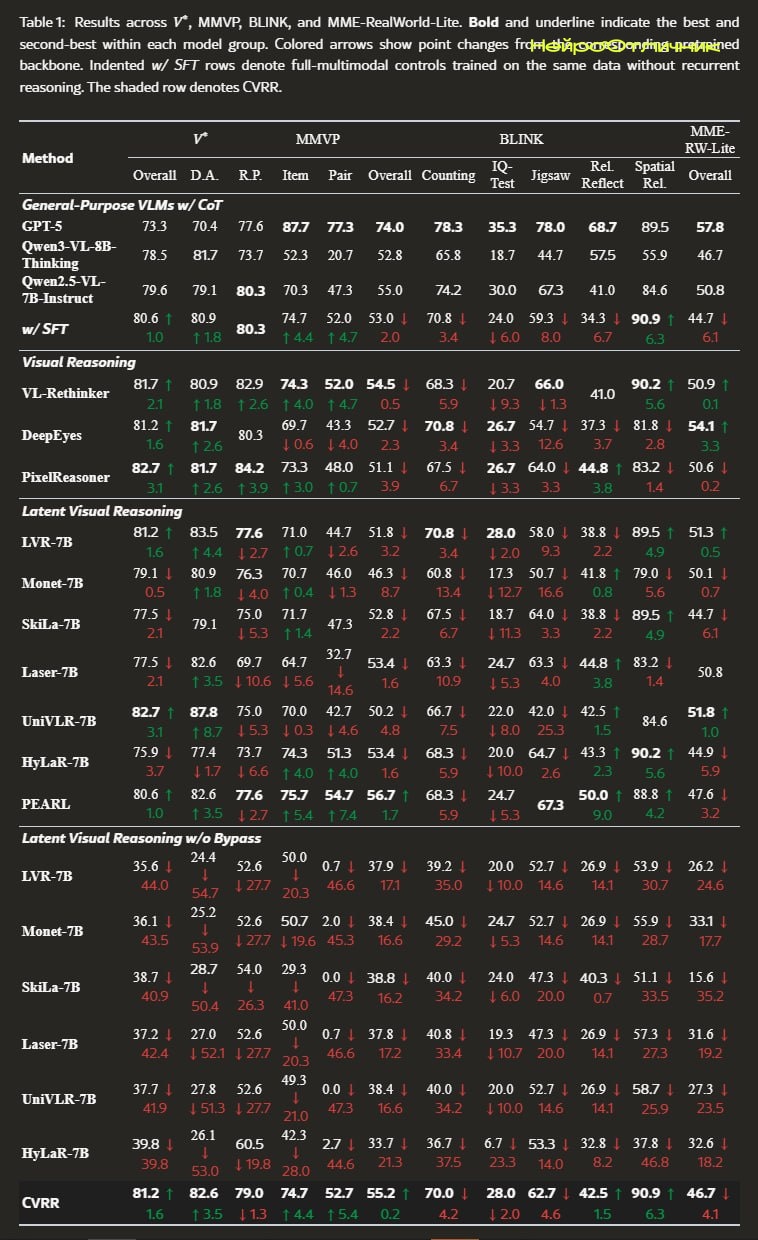
<p>В лаборатории DMIS при KAIST разработали новую модель визуального мышления — CVRR. Эта модель отличается от традиционных визуальных языковых моделей (VLM) тем, что она не полагается на прямой доступ к визуальным данным для ответа на вопросы. Вместо этого, CVRR использует рекуррентное скрытое состояние, что позволяет ей действительно рассуждать, а не просто извлекать информацию из визуальных токенов.</p>
<h2>Как работает CVRR</h2>
<p>Традиционные VLM могут "жульничать", извлекая ответы напрямую из визуальных токенов, что не всегда требует глубокого анализа. CVRR перекрывает этот путь: её декодер видит только рекуррентное скрытое состояние, а не оригинальные визуальные ряды. Это означает, что если модель дала ответ, она действительно прошла через процесс рассуждения.</p>
<h2>Доступные чекпоинты</h2>
<p>Для CVRR доступны чекпоинты на различных моделях, таких как Qwen2.5-VL-7B, Qwen3-VL-8B, Gemma3-4B/12B, Gemma4-12B и InternVL3-9B. Это позволяет исследователям и разработчикам выбирать наиболее подходящую конфигурацию для своих задач.</p>
<h2>Практическое применение</h2>
<p>CVRR может быть полезна в различных областях, где требуется глубокое понимание визуальных данных. Например:</p>
<ul>
<li>Анализ сложных визуальных сцен, где требуется больше, чем просто идентификация объектов.</li>
<li>Разработка приложений, где важно понимание контекста, а не только визуальных элементов.</li>
<li>Создание систем, которые могут обучаться на основе сложных визуальных данных без прямого доступа к ним.</li>
</ul>
<p>Таким образом, CVRR открывает новые возможности для исследований и разработок в области визуального мышления. Более подробную информацию о модели и её применении можно найти на сайте студии "Нейро Отличник".</p>
Нейро Отличник
www.neurootlichnik.ru